مبانی و راهکارهای عملی برای مقیاسپذیری سرویس ابری
مبانی و راهکارهای عملی برای مقیاسپذیری سرویس ابری
در این مقاله با تاکید بر رویکردهای قابل آزمون و کاربردی به موضوع مقیاسپذیری سرویس ابری میپردازیم. هدف ارائهٔ چارچوب تصمیمگیری، الگوها، معیارهای سنجش و مراحل عملی است تا تیمهای توسعه و عملیات بتوانند سامانههایی مقاوم، قابل رشد و اقتصادی طراحی و اجرا کنند.
مقیاسپذیری سرویس ابری
مقصود از مقیاسپذیری سرویس ابری توانایی تنظیم ظرفیت محاسباتی، شبکه و نگهداری دادهها بر اساس تغییر بار است، بدون آنکه کیفیت خدمت بهطور چشمگیر افت کند. این مفهوم شامل افزایش یا کاهش منابع، توزیع ترافیک و طراحی نرمافزاری است که امکان رشد و تحمل خطا را فراهم کند.
انواع مقیاسپذیری و مقایسهٔ سریع
دو رویکرد اصلی برای مقیاسپذیری وجود دارد؛ هرکدام مزایا و معایب مشخصی دارند:
- عمودی (Vertical): افزایش منابع یک نمونهٔ موجود (رم، CPU، فضای ذخیره). مناسب برای سرویسهایی با وضعیت محاسباتی تکنخی یا پیچیده؛ پیادهسازی سادهتر اما محدودیت فیزیکی و هزینهٔ بحرانی دارد.
- افقی (Horizontal): افزودن یا حذف نمونههای همسان از سرویس (کانتینر، ماشین مجازی). گسترشپذیری و تحمل خطا بهتر، اما نیاز به طراحی بدونحالـت و هماهنگی بین نمونهها دارد.
در عمل اغلب ترکیبی از دو رویکرد استفاده میشود: مقیاسدهی عمودی برای گرههای پایگاهدادهٔ خاص و مقیاسدهی افقی برای لایهٔ اپلیکیشن.
چرخه تصمیمگیری: سوالاتی که پیش از طراحی باید پاسخ داده شوند
قبل از هر تصمیم فنی، دستهای از سوالات کلیدی تعیینکنندهٔ جهت راهکار هستند:
- نوع بار کاری چیست؟ (درخواستهای کوتاه، پردازش دستهای، جریانهای همزمان)
- الگوی مصرف چگونه است؟ (پیوسته، فصلی، پیکهای ناگهانی)
- سطح تحمل خطا و زمان بازیابی مورد انتظار چه اندازه است؟
- محدودیتهای بودجه، هزینهٔ ساعت-ماشین و هزینهٔ شبکه چطور است؟
- آیا دادهها حالتدار هستند و انتقال حالت امکانپذیر یا مقرونبهصرفه است؟
پاسخها تعیین میکنند که ابتدا باید روی بهینهسازی نرمافزاری، توزیع بار یا افزایش منابع سرمایهگذاری شود.
الگوها و تکنیکهای کاربردی
الگوهای عمومی که در پروژههای موفق دیده میشوند:
- بدون وضعیت (Stateless): جداسازی ذخیرهٔ وضعیت از لایهٔ محاسبات تا نمونهها بتوانند آزادانه زیاد یا کم شوند.
- کَشینگ چند لایه: از کش مرورگر و شبکهٔ توزیع محتوا برای محتوای ایستا تا کشهای درونحافظه برای نتایج پایگاهداده؛ انتخاب TTL و سیاستهای حذف اهمیت دارد.
- صفها و پردازش ناهمزمان: حذف کارهای سنگین از مسیر پاسخدهی بلادرنگ و انتقال به صف برای پردازش پسزمینه.
- توزیع بار: استفاده از لایهٔ توزیعکنندهٔ ترافیک با سیاستهای سلامتی و مسیریابی هوشمند.
- تقسیم داده (Sharding/Partitioning): کاهش بار روی یک گرهٔ داده با تقسیم مجموعهها بر اساس کلید معنیدار.
- نسخههای خواندنی (Read replicas): تفکیک مسیر خواندن از نوشتن برای کاهش قفلها و افزایش توازی.
معیارها، شاخصها و آستانههای عملی
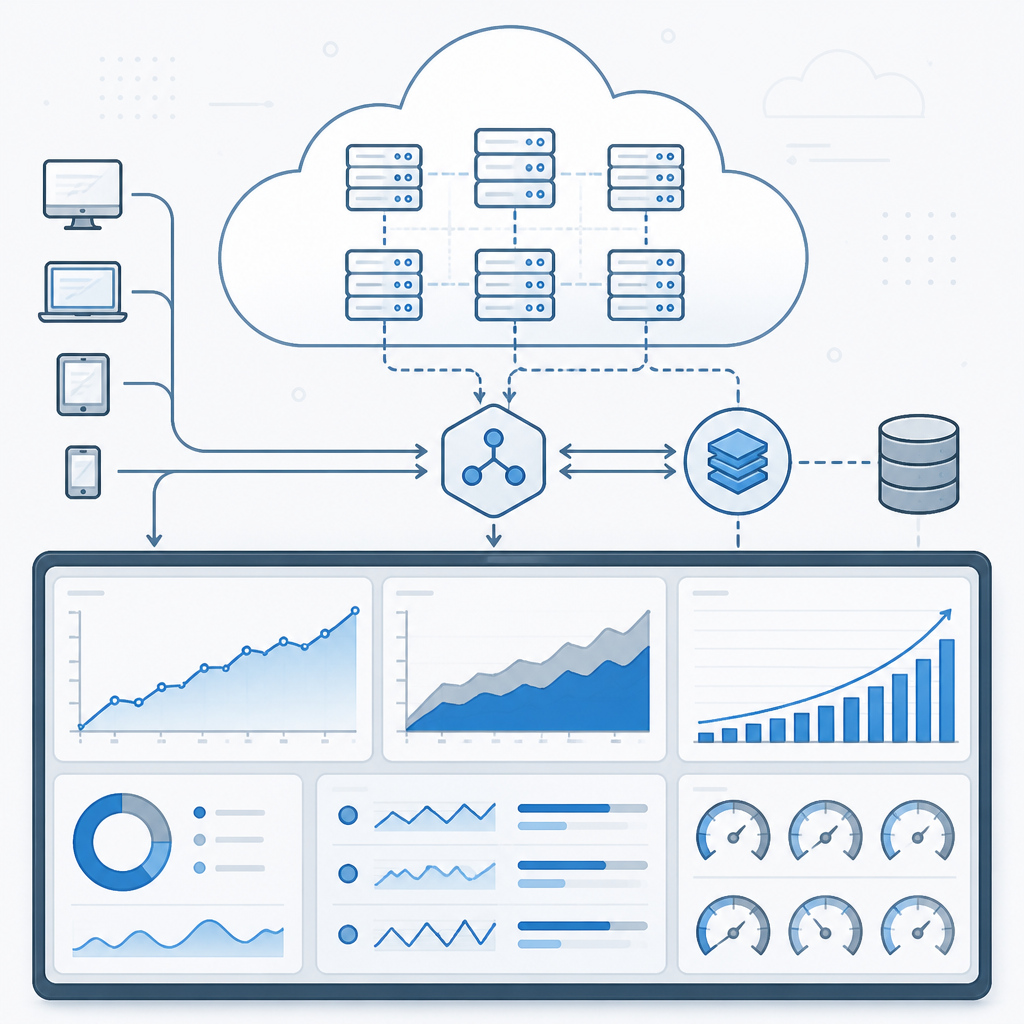
مشخصکردن KPIها و تعیین آستانهها برای مقیاس خودکار ضروری است. معیارهای پیشنهادشده و نمونهٔ آستانههای آغازین همراه با توضیح منطقی:
- Latency (میانگین زمان پاسخ): هشدار اگر p95 > 500ms بهخاطر کاهش تجربهٔ کاربری؛ مقیاسافزایی اگر p95 > 800ms برای بیش از چند دورهٔ نمونهبرداری.
- نرخ خطا: هشدار اگر نرخ خطا > 1% در 5 دقیقه؛ اگر خطاها ناشی از کمبود منابع باشند، سیاستهای خودکار میتوانند موقتاً نمونه اضافه کنند.
- استفادهٔ CPU: مقیاسافزایی زمانی که میانگین CPU > 70% طی چند دورهٔ متوالی (مثلاً سه نمونهٔ یک دقیقهای) دیده شود تا از نوسانهای لحظهای جلوگیری گردد.
- طول صف کاری: افزایش مصرفکنندهها وقتی طول صف > مقدار تعیینشده برای بیش از 2 دقیقه؛ این آستانه باید با زمان پردازش هر پیام هماهنگ شود.
- مصرف I/O و لاتنسی دیسک: برای دیتابیسها و ذخیرهسازی اشیاء آستانهگذاری جداگانه لازم است؛ افزایش I/O میتواند نشانهٔ نیاز به شاردینگ یا تغییر نوع ذخیرهسازی باشد.
این اعداد باید در محیطهای آزمایشی و براساس الگوی بار واقعی تنظیم و بازبینی شوند؛ معیارهای بومی را با دادههای تاریخی همراستا کنید.
نمونهٔ عملی توسعهٔ سیاستهای مقیاس خودکار
مراحل تعریف و آزمون یک سیاست مقیاس خودکار برای لایهٔ اپلیکیشن:
- تعریف متریکهای پایه: p95 latency، میانگین CPU، طول صف پیام و نرخ خطا.
- تعیین آستانهٔ مقیاسافزایی و کاهش با دورهٔ خنثیسازی (cooldown); مثال: اگر p95 > 700ms به مدت 2 دقیقه، افزایش یک نمونه؛ اگر p95 < 300ms برای 10 دقیقه، حذف یک نمونه.
- اجرای آزمایش بار تدریجی (ramp-up) تا پیک مورد نظر و ثبت رفتار سیستم و زمانهای راهاندازی نمونهها.
- تست سناریوهای مرزی: spike، سقوط نمونهها و بازگشت سریع بار؛ اصلاح سیاستها بر اساس نتایج و اضافه کردن آستانههای محافظتی برای جلوگیری از "پینگپانگ" مقیاس.
- مستندسازی و بازبینی دورهای سیاستها در بازههای مشخص؛ ادغام با فرآیندهای فوری انسانمحور برای شرایط غیرمعمول.
سیاستهای خودکار باید با مانیتورینگ هشداردهنده ترکیب شوند تا در صورت رفتار غیرمنتظره ورود انسانی ممکن شود و هزینهٔ اضافی کنترل گردد.
طراحی دیتابیس برای مقیاسپذیری
دیتابیسها معمولاً تبدیل به گلوگاه میشوند؛ چند گزینهٔ عملی:
- جداسازی خواندن/نوشتن: استفاده از مسیرهای جداگانه برای خواندن از نسخههای ثانویه و نوشتن به نودِ اصلی.
- شاردینگ بر اساس کلید منطقی: انتخاب کلیدی که توزیع یکنواخت را تضمین کند و مکانیزم بازتوزیع برای رشد آینده داشته باشد.
- پیادهسازی کش لایهٔ داده: نتایج پرکاربرد را کش کنید و مکانیزمهای انقضا و حذف را مدیریت نمایید تا انسجام داده حفظ شود.
- معماری eventual consistency: در مواردی که تاخیر قید سختی نیست، تحمل ناسازگاری موقت میتواند کارایی را افزایش دهد.
هریک از این استراتژیها نیازمند تحلیل هزینه-سود و سناریوهای بازیابی پس از خطا است.
الگوهای انتشار، بازگردانی و آزمون پیش از ترافیک واقعی
برای کاهش ریسک انتشار نسخههای جدید در سیستمهای مقیاسپذیر از الگوهای زیر استفاده کنید:
- آبی-سبز: نگهداری دو محیط و جابهجایی ترافیک پس از آزمون کامل.
- کینری: هدایت بخش کوچکی از ترافیک به نسخهٔ جدید و افزایش تدریجی هنگام پایدار بودن.
- بازگردانی خودکار: تعریف معیارهای خودکار برای قطع و برگشت ترافیک در صورت افزایش خطا یا افت عملکرد.
علاوه بر این، آزمونهای end-to-end و تستهای خطمشیهای مقیاس باید بهصورت خودکار در فرآیند CI/CD اجرا شوند.
هزینهها و بهینهسازی اقتصادی
هزینهٔ مقیاسدهی تنها به مصرف منابع خلاصه نمیشود؛ شامل هزینهٔ عملیات، پیچیدگی نرمافزاری و زمان تیم نیز هست. راهکارهای متداول برای کنترل هزینه:
- اولویتبندی بهینهسازی نرمافزار (پروفایلینگ، بهبود پرسوجو و کشینگ) پیش از افزایش منابع فیزیکی.
- تعریف سیاستهای روشن برای مقیاسکاهش (scale-in) تا منابع بلااستفاده حذف شوند و هزینهها کنترل شوند.
- استفادهٔ هوشمندانه از انواع منابع کمهزینهتر برای بارهای پسزمینه و پردازش دستهای.
- محاسبهٔ هزینه به ازای درخواست (cost per request) و بازبینی دورهای برای تصمیمگیریهای معماری.
چکلیست عملی برای اجرا (مرحلهبهمرحله)
یک چکلیست برای آغاز کار و آزمون سیستم:
- تعریف اهداف عملکردی و آستانههای KPI.
- شناسایی نقاط حالتدار و برنامهریزی برای جداسازی حالت.
- طراحی استراتژی کش و تعیین TTLها و سیاستهای invalidation.
- انتخاب معماری صف و تعریف پردازشکنندهها و نرخ مصرف.
- تنظیم مانیتورینگ، داشبوردها و آلارمها با نمایش p50/p95/p99.
- تعریف و آزمون سیاستهای مقیاس خودکار با بار شبیهسازیشده و سناریوهای مرزی.
- تهیه برنامهٔ بازیابی از خطا و تمرین آن به صورت منظم.
نمونهٔ عملی: سرویس وب فروشگاهی
سناریو: یک فروشگاه اینترنتی که در روزهای تبلیغاتی ترافیک آن تا 8 برابر افزایش مییابد. توصیهها و ملاحظات فنی:
- پیادهسازی لایهٔ اپ بدونحالت؛ وضعیت تراکنشها در پایگاهداده نگهداری شود و لاگها به یک مخزن مرکزی ارسال گردد.
- کَش صفحات محصول با TTLهای تفکیکشده: مثال، 5 دقیقه برای قیمتهای پویا و 24 ساعت برای توضیحات؛ استفاده از مکانیزم invalidation برای بروزرسانی آنی اطلاعات حیاتی.
- استفاده از صف برای پردازشهایی مانند ارسال اطلاعرسانی و گزارشگیری؛ تعریف مصرفکنندههای قابل مقیاس و الگوریتم افزایش بر اساس طول صف.
- تفکیک تراکنشهای خواندن و نوشتن در دیتابیس؛ برای گزارشگیری از دیتای موقت میتوان از کَش یا نسخهٔ ثانویه خواندنی استفاده نمود.
- آزمون فشار: اجرای چندین تست با افزایش تدریجی تا رسیدن به 10 برابر بار پایه، ضبط p95، نرخ خطا، زمان راهاندازی نمونهها و هزینهٔ برآوردی.
بازبینی پسرویداد برای بهینهسازی هزینه و سیاستها ضروری است.
موانع رایج و راهکارهای مقابله
- گلوگاه دیتابیس: از کش، شاردینگ یا تفکیک مسیرهای خواندن/نوشتن استفاده کنید و سناریوهای تراکنشی را بهینه کنید.
- وابستگی حالتدار: حالت را به سرویسهای ذخیرهٔ متمرکز یا پایگاهدادههای اختصاصی منتقل کنید تا نمونههای محاسبات بدونحالت باشند.
- افزایش هزینهٔ ناخواسته: سیاستهای خودکار را با آستانههای محافظتشده و سقفهای ماهیانه ترکیب کنید.
- پیچیدگی عملیاتی: مستندسازی، آزمونهای خودکار و ابزارهای مانیتورینگ را توسعه دهید تا پیچیدگی قابل مدیریت باشد.
ابزارها و منابع برای مطالعهٔ بیشتر
برای تعمیق دانش در حوزهٔ طراحی سیستمهای مقیاسپذیر، خواندن مقالات مروری و مطالعات موردی توصیه میشود. یک مرجع عمومی برای مفاهیم مقیاسپذیری در علوم کامپیوتر را میتوانید در این صفحه پیگیری کنید: https://en.wikipedia.org/wiki/Scalability_(computer_science). همچنین، پیادهسازی و آزمون در محیطهای کنترلشده کلید موفقیت است.
پرسشهای متداول (FAQ)
۱. چه زمانی باید از پیش برای مقیاسپذیری برنامهریزی کنیم؟
بهترین زمان از ابتدای طراحی معماری است؛ اما اگر منابع محدود دارید، ابتدا الگوهای پایه مانند جداسازی حالت و کش را اجرا کنید تا هزینهٔ تغییرات بعدی کاهش یابد.
۲. آیا همیشه مقیاسپذیری افقی مناسبتر است؟
خیر؛ مقیاسپذیری افقی مزایای توزیع و تحمل خطا دارد ولی پیچیدگی عملیاتی و هزینهٔ شبکه را افزایش میدهد. برای بارهای محاسباتی سنگین، مقیاسافزایی عمودی ممکن است کاراتر باشد.
۳. چگونه سیاستهای مقیاس خودکار را بدون ریسک پیاده کنیم؟
ابتدا در محیط آزمایش شبیهسازی بار انجام دهید، آستانهها را محافظهکارانه تعیین کنید، از دورههای خنثیسازی استفاده کنید و با داشبوردهای هشدار نظارت فعال داشته باشید.
۴. چه متریکهایی بیشترین اثر را روی تصمیمگیری دارند؟
p95 latency، نرخ خطا، طول صف پیام و مصرف CPU از متریکهای کلیدی هستند؛ اما انتخاب باید با نوع بار و نیازهای کسبوکار مطابقت داشته باشد.
۵. چگونه از رفتار غیرمنتظره هنگام مقیاسافزایی جلوگیری کنیم؟
از آستانههای محافظتی، سقف تعداد نمونهها، دورههای cooldown و نظارت بر هزینهها استفاده کنید. همچنین، تستهای واقعی و سناریوهای fault-injection کمک میکنند تا نقاط ضعف آشکار شوند.